如何理解算法复杂性结果:「计算模型」介绍
最近,OpenAI 发布的一批算法研究成果引发关注,其中有两条是:整数乘法/FFT极限的时间复杂度可以突破 O(n log n)。然而早在1972年,研究者就已经证明整数乘法至少需要 Ω(n²) 的计算代价。是谁错了?
为什么同一个问题会得到截然不同的结论?本文从整数乘法、矩阵乘法到 FFT,带你揭开算法复杂度背后容易被忽略的前提。
作者:silverxz
审核:emmm
2026 年 10 月 6 日,OpenAI 发布了 722 篇论文的草稿,其中不乏理论计算机科学领域的重要成果(若核实为正确),尤其是一些经典问题上的令人惊讶的复杂度改进。然而,许多人在传播这些成果的时候,做了过度的简化。有人这样列举:
…
编号 130,FFT 极限并不是 ,可以达到 。
编号 109,整数乘法也不是 ,可以达到 。
…
这种列举可能有利于传播,却不利于理解这些结果的实际含义,甚至有误导之嫌。它把「问题」和「复杂度」列举出来,建立起了一种可能误导他人的对应关系,却忽视了同样必不可少的第三个对象——决定如何衡量复杂度的「计算模型」(model of computation)。这就是本文要介绍和澄清的:在谈论算法复杂性之前,要先弄清楚它采用的计算模型是什么,仅仅盯着一个大O记号是不够的。
OpenAI 发布的这些待验证成果恰好涵盖了各种各样的计算模型,我们可以在讲解的同时,以它们为例子,理解这些成果的含义。不过提醒一下,OpenAI 的这些结果仍然待验证,我们这篇文章并不讨论其具体技术和正确性,只是理解这些结果的字面意思。
本文的内容大致是对算法复杂性的“进阶理解”,因此,本文假定读者对算法复杂性已经有简单的理解,熟悉 等渐进记号,这要求读者有计算机科学专业本科低年级的知识水平,或者有算法竞赛经历。若读者略有遗忘,可以参考以下定义:
引子
考虑以下的二重循环。
1 | int sum = 0; |
若读者已经对算法的复杂性有一定了解,可能扫一眼就会说:这段代码的计算复杂性“显然”是 .
那么,这是为什么呢?
如果要求你仔细拆解,你可能会说:因为这段代码执行了 次加法运算和 次赋值运算。如果更细节一点,你可能还会补充,它们还执行了对 a[i][j] 的访存,这种访存也一共执行了 次。由于这些操作执行一次的代价是 的,累加起来的代价就是 .
的确,我们平时就是这么分析算法复杂性的。对于加、减、乘、除、赋值、随机访存……这些基本的运算,我们通通认为它们是 的。
但这并不是理所应当的。实际上,这是为了计算算法的复杂性而主动做出的一个选择。当你选择了让这些操作的复杂性为 时,你就可以基于这一选择来计算整个算法的复杂性。选择本身没有正不正确的说法,但是不同的选择会得到不同的答案,也具有不同的意义。
为了理解这段话,我们考虑一个乘法版本的二重循环,这次用 Python 来写(因为 Python 的整数是任意精度的,只要内存允许,它可以一直变大、不会溢出):
1 | def compute(n): |
它的复杂性是什么?
如果认为执行一次乘法的代价是 ,即计算 product * 2 的代价是 ,那么这个函数的总代价仍然是 . 但是真的运行起来,你会发现它和上一个二重循环截然不同,因为中间结果在指数膨胀,当 较大时,乘法会随着中间结果的膨胀而变得很慢很慢。如果读者亲自实现过高精度加法、高精度乘法,那么当然就会明白,整数的加法和乘法的耗时是一个和整数位数有关的量,此时默认它们总是 就偏离实际表现了。
读者可能会说,“好啦,我明白啦。你无非就是想说,当整数很大的时候,认为整数运算是 的做法错了。那是当然,这太简单了,还用你说……”——且慢,我可没说它错了。还记得我们之前说的吗?把什么当作 ,这是一种选择,而选择本身是中性的,没有绝对的正确与错误,只看这种选择是不是你想要的。如果有人说,“在乘法 的前提下,上述算法的复杂性是 ”,这完全正确,只不过这种复杂性不能良好反映这段 Python 代码在典型机器上的运行表现。于是你可以说,“你说得对,但这样的选择不是我想要的”,也可以更直接地说,“别说废话”,但那句废话仍然是对的。
读者可能不理解为什么我如此纠结于这里的表述。这是因为,在理论计算机科学中,许多问题的复杂性分析都有不止一种合理的选择,没有哪个是绝对正确的,只取决于你想要什么。整数乘法和 FFT 都是很好的例子,我们先来看前者。
整数乘法与图灵机
在 OpenAI 发布的预印本 Integer multiplication below n log n 中,他们在摘要里这样说:
We give a deterministic algorithm that multiplies two n-bit integers in worst-case time, with , on one fixed finite-alphabet Turing machine with a fixed finite number of one-dimensional tapes.
我们给出了一个确定性的算法来计算两个 n-bit 整数的乘法,最坏时间复杂性 ,其中 ,在一个有固定有限字母表、固定有限数量的一维条带的图灵机上。
这里加粗的内容就是所谓的计算模型。
读者不用具体了解图灵机的细节,只需要知道图灵机具有一个或多个无限长的一维条带。一维条带的意思是,它是一格一格排列起来的,这些条带就起到内存的作用,而格子就是内存单元。每个条带配备一个可以移动的读写头,每次只能对读写头所在的格子进行读写,若想要对其他格子进行读写,就要一格一格地把读写头挪过去。在这种计算模型下,通常默认读写头的一格移动、一格读写是 的,这就是这一模型做出的选择。下图是图灵机的一个示意图。
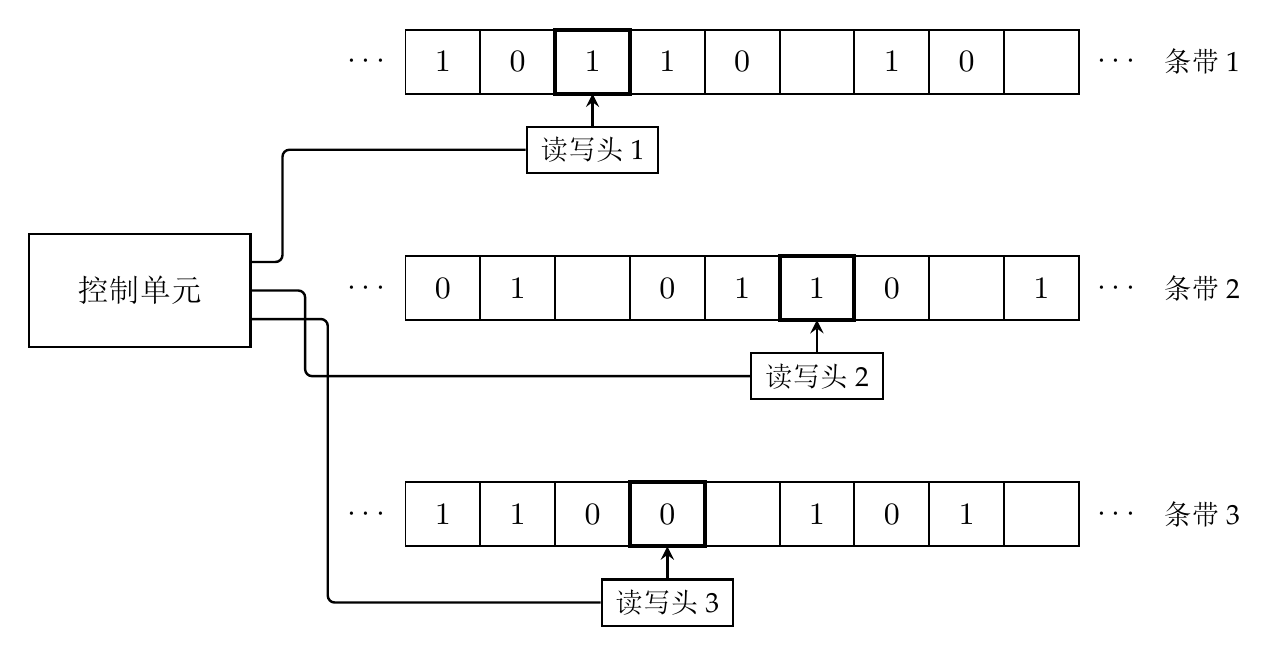
可以注意到,虽然条带起到了内存的效果,但是读写远距离格子需要把读写头一格一格挪过去,而不能像通常的内存那样,做随机访存。所谓随机访存,就是指 a[r] 这样的利用变量 在内存中直接寻址访存的操作,这在图灵机里是不能直接完成的。如果读写头在 a[0] 处,图灵机想要读写相距 个格子的 a[r],就必须移动 次读写头才能读写,付出 的代价。
这种底层细节带来的影响是切实的。具有多个条带的图灵机有多个读写头,这变相允许了更灵活的内存访问,而 OpenAI 证明的那个结果正是建立在这样的具有多个条带的图灵机上。如果仅允许一个条带(再配备一个额外的只读条带作为输入),Juan Bulnes 在 1972 年证明了 的下界。
所以,如果我们不在讨论复杂性之前说清楚选择的计算模型,说清楚如何计算操作的代价,仅仅盯着渐进记号看,就会有很荒谬的矛盾结果:一个问题怎么可能既是 的又是 的?现在我们知道了,它们并不矛盾,只是选取了不同的计算模型。这两个计算模型的区别仅仅在于图灵机允许的条带数量,这也正说明了计算模型的微小改变可以导致复杂性有重大差异。这是我想通过这个例子告诉读者的。
这也会修正我们在初学者时期的一些直觉。初学者可能认为,一个问题对应一个唯一的、真正的“最优复杂性”等待人类求解,但事实完全不是这样,这种想法忽略了计算模型的影响。忽略计算模型的表述在宣传上更有利,“整数乘法突破了!”明显比“整数乘法在多条带、有限字母表图灵机上的复杂性突破了”更 exciting,更像个大新闻。但是后者才是事实,这种看似冗长的表述是内容实实在在的一部分,既尊重其实际成果,也不会贬损其真正的分量。
初学者还可能认为,一个问题的复杂性上下界反映了这个问题的某种客观难度。在粗粒度的复杂性分析中,这一定程度上是对的,因为各种合理的计算模型之间往往可以多项式地规约,所以一个 P 问题(多项式时间可判定的问题)不会因为条带数量的改变而变得不是 P 问题,于是我们可以认为 P, PSPACE… 这些复杂性类确实一定程度上刻画了这些问题的“本质困难程度”。然而在“锱铢必较”的细粒度复杂性中,像我们刚才看到的那样,问题的复杂性上下界就与选择的计算模型高度相关了。
读者可能还有一堆别的问题,比如“我觉得这两个图灵机模型都很怪,它们都不能随机访存,为啥要在这些模型上考虑”,“有没有更接近实际的模型”……如果单论整数乘法这个问题,想要找到一个切合实际的模型其实并不容易,这个问题的深入讨论会很复杂。但如果是想要了解更多的模型,尤其是那些允许随机访存的模型,那当然是——有,还有很多。我们可以换下一个问题看看。
子集和问题与 Word-RAM
OpenAI 在“子集和问题”(Subset Sum)上也尝试做出了两篇工作。这个问题的定义是这样的:给定 个正整数 和一个目标正整数 ,问能否选出其中的若干个数(不允许重复选择),使这些数的和恰好为 ?
OpenAI 的预印本标题是 Subset Sum in Time ,现在我们知道了,只看这个 是不够的,要想理解这个结果,得追问他们采用怎样的计算模型。就像整数乘法那样,我们先看论文的摘要:
We give a uniform randomized classical algorithm for Subset Sum with bounded error and worst-case running time on polynomial-bit inputs in a word-RAM model, where n is the number of input integers.
我们给出了子集和问题的一个一致、经典、错误率受控的随机算法,当输入 bit 数为(关于 的)多项式级别时最坏运行时间为 ,在 word-RAM 模型上,其中 是输入整数的数量。
这个结果是对 Chen–Jin–Randolph–Servedio 2023 的 的一个改进,它把指数上的 改进到了 ,看似微小,但已经是很有突破性的改进。
这里我们看到了一个新的计算模型,叫 word-RAM. 它很好理解,完全是字面意思:RAM(Random-access machine, 随机访问机)意味着这个模型允许随机访存,而 word 则意味着这个模型允许以 word(字)为单位做运算,且认为这种运算是 的。
Word-RAM 不是一“个”模型,而是一类模型。为了确定一个具体的 word-RAM 模型,我们需要指定一个字包含的 bit 数,即字长 ,再指定一个字允许进行怎样的 运算。后者通常是约定俗成的,允许读写、加法、减法、位运算等,主要的分歧在于是否允许 乘法、带余除法、取模。所以可以说,字长 是 word-RAM 的主要参数,接下来我们讨论一下字长的选择。
若设定为固定的 ,那么就和我们现在常用的机器比较相近。不过,最常见的 word-RAM 模型的字长并不是固定的常数如 ,而是变长的,随着输入规模改变。一般来说,若问题的输入规模为 ,则模型的字长 . 为什么要这样呢?这是因为,一个字至多能存放 种不同的地址,若是常数,那么一个字能寻址的内存大小就也是常数,如果想要寻址内存的第 个位置,就需要 个字来存放这个地址,很麻烦。虽然这样的模型也可以考虑,但更常见的做法是,干脆让 跟着 一起增长,使我们总是可以只用一个字来编码地址。注意我们对字长的描述也可以使用渐进记号,因为差一个常数因子不会改变复杂性的渐进表现。
这样得到的 word-RAM 模型具有比我们刚才提到的图灵机更强的能力,因为这个模型认为字之间的运算是 的。因此,两个 -bit 的整数加法在 word-RAM 中是 的,但是在只能逐位处理的图灵机中,却有 的下界。
但是注意我们刚才的表述,,而不是直接令 ,这是为什么呢?这是因为, 通常只是为了寻址做的一个基本的要求,对于特定的一些问题,有时候还会有更多要求,使字长被进一步放大。比如对于一些整数相关的问题,常常希望把每个整数都能放到一个字里,此时就会要求字长比这些整数更长。
比如对于子集和问题,设
也就是说, 是输入的这 个整数的最大长度。在这一问题中,通常进一步要求 word-RAM 模型的字长 .
我们已经看到,word-RAM 的字长 和允许的指令都会影响模型的强度。那么现在一起来看一看,OpenAI 这篇文章选择了怎样的字长和指令呢?这种参数选择即便没有写在摘要,也会写在很靠前的位置。事实上,论文开篇就写明了,允许乘法、带余除法、取模,并且有字长
也就是说,. 这可和我们刚才讲的不一样,这里多了一个 。按照论文第26-27页的分析可以看出,这是为了保证算法运行过程中所用到的内存也都能被一个字寻址。到这里,我们可以说已经弄清楚了这篇论文宣称的结果究竟处于什么模型下。
可是在 OpenAI 之前,Chen–Jin–Randolph–Servedio 2023 给出的子集和问题的前沿成果所使用的字长假设是 ,基本可以理解为 (因为大于 的 可以直接删去,因此不妨设 ,此时 和 是同一量级)。这意味着,当 不能合并到 里时,这两个 word-RAM 模型并不等价!比如 时,OpenAI 选择的 word-RAM 模型比 Chen–Jin–Randolph–Servedio 2023 选择的更强,它们不再是同一个计算模型了。如果是这样,就不能宣称 OpenAI 改进了 Chen–Jin–Randolph–Servedio 的结果,它们无法直接比较。
——好在这个乌龙没有真的发生。实际上,对于子集和问题来说, 的情况并不重要。原因是经典的背包算法就有 的结果,当 时,这个简单的背包算法就比 OpenAI 和 Chen–Jin–Randolph–Servedio 给出的结果都更优。也就是说, 的情况可以交给背包算法,在这一语境下不需要关心,因此可以默认 ,此时 ,两个模型只差常数。类似的论述其实也在 Chen–Jin–Randolph–Servedio 2023 呈现过,算是既有约定。因此,若 OpenAI 的这一结果被核验无误,就确实是一个实质的改进。
就此,我们跟着这个例子,大致了解了 word-RAM 模型,也看到了该如何比较两个结果:必须要仔细对比两个结果所采用的模型才行。如果两个结果使用的模型有差异,这虽然不一定意味着它们不可比较,但是这种比较必须建立在仔细的分析之上。这是这个例子想要告诉读者的。在 FFT 那里,我们还会看到一个类似的分析过程。
以防读者误解,还是要澄清一下:我们在 word-RAM 上讨论子集和问题,这并不意味着它就“理应”在 word-RAM 上研究。我们完全也可以按照 bit 来计算代价(一种 bit-cost RAM):此时一个 -bit 整数不再被视为一个原子,整数的加法、乘法、比较等操作都要按照实际需要处理的 bit 数计算代价。对于这里所考虑的 的输入而言,把一个 word 上的算术操作展开成多项式那么多个 bit 操作,只会额外产生一个关于 的多项式因子,可以吸收到原论文更强、更精确的结果的多项式因子中,再进一步根据 的多项式假设得到相同的 , 没有影响 OpenAI 对指数 的本质改进。
我们也可以回到图灵机上研究这个问题,只不过需要为访存付出额外的代价。正如我们之前说过的:使用什么计算模型,这常常是一种选择,而不是“某个问题就该对应某个正确的模型”。
矩阵乘法与算术复杂性
刚才我们讨论图灵机和 word-RAM,好像计算模型就是这种“能力从弱到强、排序分明”的家伙。如果前面的内容给了你这样的错觉,那希望接下来的例子能澄清它。
OpenAI 发布了一篇关于矩阵乘法的预印本An Upper Bound of 9/4 for the Matrix Multiplication Exponent,摘要是这样的:
We prove that the exponent of matrix multiplication over the complex numbers is at most 9/4.
我们证明了复数域上矩阵乘法的指数至多是 9/4.
只能说是“字越少,事越大”了,这是很重大的结果,并且从文章表现出的迹象来看, 有可能只是这一方法的起点。当然,具体情况还需要后续核验。
与前面两个例子不同,这里 OpenAI 没有在摘要中写出他们使用的计算模型。这是因为,这一问题有长期以来默认的模型。为此,我们先介绍这个问题本身。
这个问题和那些定义在图灵机或是 word-RAM 上的问题有根本的区别。它是这样描述的:设有两个 矩阵 ,矩阵的元素取自复数域 ,现要求根据矩阵 中的元素和预先选定的复数常数,通过复数的加、减、乘三种运算计算出矩阵 的每一项,问,最少需要多少次复数运算?——从这个定义可以看出,它把复数的加、减、乘都视作 .
这个定义是一个粗略阐述,实际上要再复杂一些。注意到,问题不能允许你对每一对具体的矩阵 都特殊处理,否则你只要把选定答案作为复数常数然后直接输出它就可以了,那太无聊了。所以严格来说,问题只允许你对每个 做单独处理,但是对于相同的 ,你必须使用同一套常数和机械的运算方法来得到最终的答案。这套机械的计算方法会呈现为一个电路图/有向无环图的形式,这里的电路并不是物理上的真实电路,而是沿用计算复杂性领域的术语。
比如对于 矩阵的乘法运算,如果你决定暴力计算,即
那么画出来的电路就是下面这样的:
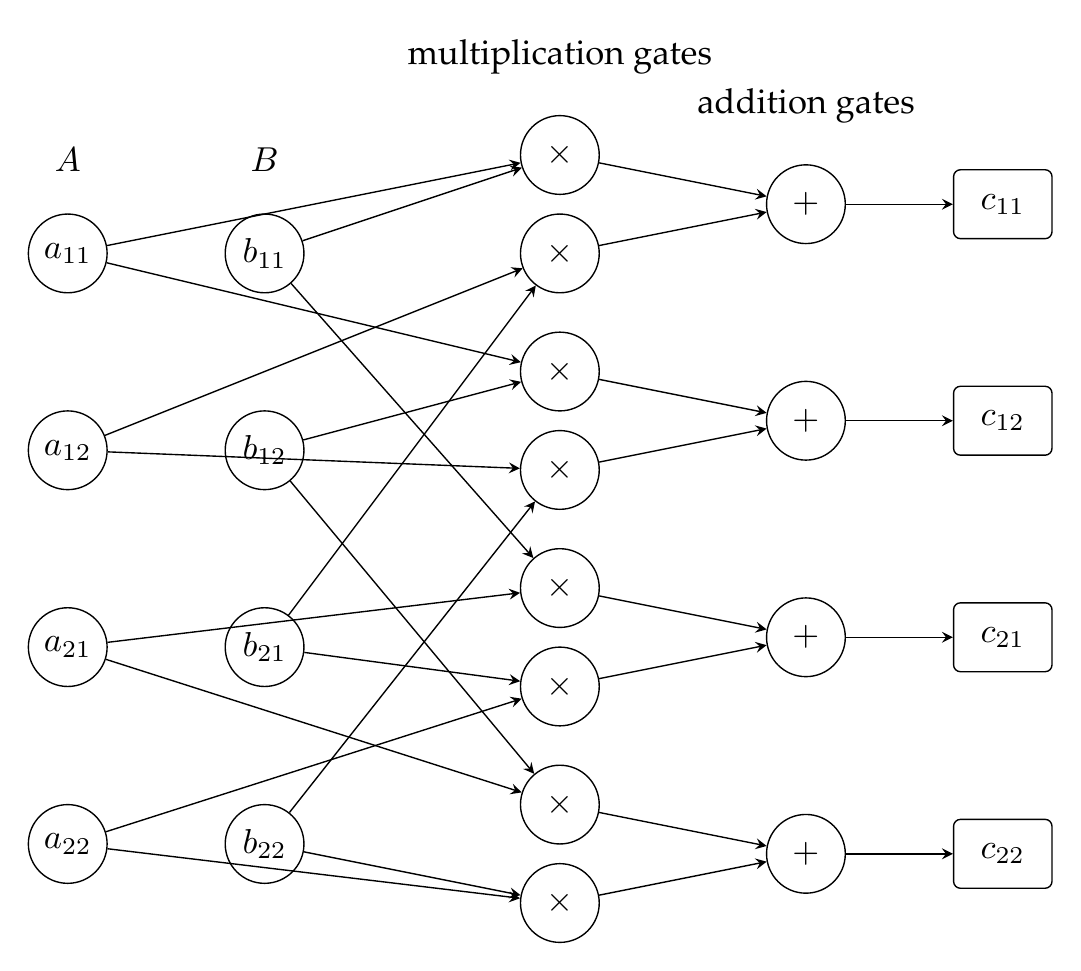
只需要数一数图里有多少个乘法门和加法门,就知道它的运算次数: 次, 次乘法、 次加法。如果对于一般的 也这样计算,就需要执行 次乘法和 次加法,运算次数 . 那些更巧妙的算法可以不这么计算,而是构造出一些易于复用的中间结果——同一个中间结果只需要被计算出一次、承担这一次的计算代价,就可以供后续运算多次使用,从而优化整个计算过程的总运算次数。这里最经典的非平凡优化是 Strassen 算法,可以在 次运算内解决这个问题。它不复杂,但对应的电路图画出来太大,感兴趣的读者可以自行了解。总而言之,矩阵乘法就是这样的一个问题。
这种复杂性度量方式叫做算术复杂性,你可能觉得,这不就和我们最熟悉的复杂性一样吗,我们只需要数一数运算次数就行?但这里在更根本的地方发生了改变:这种问题和那些定义在图灵机上的问题根本不是同一种问题,其解法和图灵机上的算法也不是一回事。在这种度量下,我们只关心计算过程在代数上对应的结构,不关心参与运算的数如何被编码、存储、寻址访存、控制精度……也不关心这些运算如何在实际机器上执行。
在这里,它允许使用任意的复数,这在通常的图灵机(以及 word-RAM 和真实机器)上就是不可能的(这算是一条关于无穷集合的数学定理,我们不在这里解释)——这意味着这里处理的问题与图灵机上处理的并不是同一类问题,我们不需要考虑编码、考虑精度等等。其次,这里允许对每个 单独处理,这意味着不一定存在一个图灵机上的算法能统一处理所有不同的 (这种情况叫 nonuniform)。可以想象,如果不同的 之间的处理方法没有什么规律的话,想要写成算法,你就不得不写成"if n==1, ...; if n==2, ...; if ...",用条件语句特判每一个 ,那就不是一个有限的程序了——这就意味着,这里的“算法”也不同于图灵机上的算法。
这种差异不是必然存在的,它也可以只使用性质良好的复数常数、或者让电路 uniform. 在性质足够好的情况下,它确实也可以有一个图灵机上的对应算法;但是,它也可以没有,我们不能直接断言它总是有。
回到 OpenAI 的成果,它的意思就是:在上述的定义下,矩阵乘法至多只需要 次复数运算,其中 任取,但大O记号中的常数依赖于 的选取。这个问题太过基本且重要,领域多年的研究让 OpenAI 无需在摘要里再把这一套语境复述一遍,但细究起来,它是建立在上面这一套定义下的。
FFT 和……
经过了几个例子,我们来到了 FFT. 我们习惯于把它叫 FFT,不过严格来说,这个问题应该叫 DFT (discrete Fourier transform, 离散傅里叶变换),而快速傅里叶变换 FFT 是它的一类经典算法。读者甚至不需要知道具体什么是 DFT,只需要知道它是“给定 个复数、输出另外 个复数”的线性变换就足够了,这个问题就是要把另外 个复数算出来。OpenAI 这里处理的是所谓的“未归一化的 DFT”,我们也默认讨论这个问题。
理论上,我们不需要单独开一节讲述这里的内容了,因为分析和理解这些内容的方法在前面几节已经陈述过。如果读者吸收了那里的分析范式与方法论,那读者自己就能理解这些关于 DFT 的工作是什么意思。
但是这是“理论上”。DFT 世界之深邃混沌堪称恐怖,所以我们还是要领着读者走一遍,算是一次“实战模拟”。我们不可能介绍整个 DFT 领域,所以这次还是沿着 OpenAI 的预印本An explicit power saving for the exact discrete Fourier transform走,我们想要解答以下几个问题:
怎样表述和理解 OpenAI 的这个结果?
这一结果改进/打破了什么?又有哪些“平行”的结果没有受到影响?特别地,这个结果和实际机器运行的算法有什么关系?
提问时间:为了理解其结果,现在应该做点什么?
——去看摘要。当然。
摘要是这样写的:
We give a deterministic algorithm that computes the discrete Fourier transform at every length n in operations. The model uses exact complex arithmetic, unrestricted coefficients, specified Fourier roots, and unit-cost logarithmic-size indexing; scalar preparation and array organization are included.
我们给出了一个确定性算法来计算长度为任意 的 DFT,操作数 . 模型使用精确复数算术,无限制的系数,特定的傅里叶根,单位代价的对数尺度索引;标量的准备和数组的组织也包含在内。
很符合我们期望的结构:一个 算法,在一个模型上。但是这个模型……怎么有点看不懂呢?什么乱七八糟的?看起来,我们得去翻正文来确定这些描述模型的短语是什么意思。
——经过了一番阅读,现在可以这样解释这些短语:
精确复数算术:模型不考虑复数运算的精度和数值稳定性,所有复数运算都是精确的,且.
无限制的系数:复数系数和中间量的模长不设上界。
特定的傅里叶根:对于每个 ,算法可以从模型中 获得一个特定的傅里叶根,用于算法执行(有一点可计算方面的细节我们跳过)。
单位代价的对数尺度索引:模型有一些整数地址寄存器,可以按地址进行访存。若地址的长度在 -bit 以内,则这样访存的代价是 的。
标量的准备:虽然模型允许全部的复数运算,但是 OpenAI 的算法给了自己更严格的限制,只允许在一个准备阶段构造好一些输入无关的标量,而输入的 个数只会和这些准备好的标量相乘。这一准备阶段所执行的运算,也按以上描述计算代价,即“包含在内”。
数组的组织(的代价)也包含在内:这不算是个新要求,只是一个附带的提醒。
有没有感觉有点混乱或是抓狂?这不是任何经典的、标准的模型,而是 OpenAI 自己定义的一个模型,所以包含了繁多的细节。事实上,为了简化,我还略去了其中一小部分内容。
现在我们才能表述 OpenAI 得到的直接结果,像他们的定理 1.1 那样:在上述模型下,有一个确定性的算法,在的复杂性内解决 DFT 问题。如果要展开的话,就是上面那一大坨。但是无论如何,“在上述模型下”是不可或缺的,如果换成一个不提供单位根的模型,或者不能做这种随机访存的模型,算法很可能就不能成立;反过来,如果不计算准备的代价,或者允许更多更快的运算,那算法说不定还能更快。——都已经到这儿了,我想不用我再啰嗦一遍了,复杂性是建立在计算模型之上的。
那么读者可能会感到困惑:这个结果建立在如此特殊的一个模型下,那么它的意义是什么?这就需要对照 DFT 的其他既有结果了。
在经典的“无限制线性电路模型”中,之前的最好结果是只需要 次运算。那么 OpenAI 的 算不算是对此的改进呢?这就需要比较这两个模型的强度。
粗略地说,所谓的“无限制线性电路模型”,就是指:常数无上界(对应 OpenAI 模型的第 2 条);输入只允许做线性运算,即可以加减,但乘法只能和标量相乘(对应第 5 条,虽然 OpenAI 的模型本身可以做一般的复数乘法,但他们特意限定了算法过程中输入仅能与准备好的标量相乘);复杂性仅计算运算次数,运算是精确复数运算(对应第 1 条);并且使用的常数可以任取,当然也就包含第 3 条的傅里叶根。
这意味着,在该算法的使用场景下,OpenAI 的模型是一个要求比“无限制线性电路模型”更多的模型。不仅如此,OpenAI 模型的复杂性计算还要计算访存——虽然随机访存是 的,但是电路模型甚至不计算访存代价,它都没有内存的概念。所以,一个在 OpenAI 模型上运行的算法可以直接迁移到“无限制线性电路模型”上面去:只需要把准备的常数直接变成电路常数,再把后续的运算变成电路中的运算门,索引、访存等直接改成在电路里连线即可,其复杂性只会降低,不会升高。从这里我们也能看出,OpenAI 定义的这个模型看似很复杂,其实有不少是对自己的限制而非便利,是在提升结果的强度。
这也就是说,既然论文称能在 OpenAI 的模型下达到 ,自然也就能在“无限制线性电路模型”下达到 。虽然两个模型不同,但是这是我们通过比较两个模型的强度关系得出的结论。——这正是 OpenAI 这一结果的主要突破,这个 的上界已经很多很多年没有被推进了。
另一方面,既然有“无限制线性电路模型”,就有“有限制”的,比如“有界系数线性电路模型”,它要求系数必须有一个和 无关的上界。那么 OpenAI 的结果还能迁移到这样的模型上吗?
——答案自然是不能,因为 OpenAI 的模型已经在第2条声明了,它们不要求有界。事实上,这种迁移是不可能的,因为 Morgenstern 在 1973 年证明了“有界系数线性电路模型”上的 DFT 有复杂性下界 ,这也说明 OpenAI 的算法一定使用了无界的常数。都读到这里了,相信现在读者不会再困惑“为什么一个问题可以既有 的结果,又有 的结果”了。
DFT 还有不少其他的模型,但是篇幅所限,我们就不介绍了。剩余的篇幅回答一个读者可能关心的问题:那 OpenAI 的这个结果对“现实”中的 DFT 有什么影响?“无限制线性电路模型”,“有界系数线性电路模型”,以及 OpenAI 的模型,哪个才是“现实”的?——答案是,都不。
在这几个模型中,它们最关心的其实都是复数的运算次数,于是建立在“精确复数算术”的假设下。然而在现实中,复数的存储和精度就不得不予以考虑了。
这些模型对精度不予考虑,并不是它们的失误,而是有意为之,试图尽可能忽略复数表示、数值精度等其他困难,专门考察“实现 DFT 这一线性变换至少需要多少次运算”这一算术层面的困难。这确实只是 DFT 困难性的一个方面,还有许多其他方面,如数值稳定性、具体机器实现下的代价、并行计算代价、特殊情形的代价……它们会发展出其他的工作。
并不是每个工作都能让实际应用中的 DFT 更快,但所有这些成果共同加深了人类对 DFT 的理解。其他问题也是如此,那些经典问题常常不是单一的,复杂性研究也不是沿着一条线性的轴推进,它们是多角度的,甚至于角度本身也依赖人们发掘,理论计算机科学的一部分繁荣与“混乱”就在于此。
那些完全抛弃掉计算模型的“成果转述”,把人们在复杂性方面的工作宣传得像是赛跑破纪录一样。可是就连赛跑,也有不同的里程、不同的环境,有接力有跨栏……那样的表达在宣传上有力,在理解上无疑是失当的,相当于还没有理解。
本文看似像是计算模型的博览会,但其意图并不是讲解几个具体的计算模型,而是希望授之以渔。计算模型千千万万,讲是讲不过来的。但是读者知道有这家伙的存在,知道了理解复杂性结果更好的方法,那么未来再看其他成果、学习自己感兴趣的问题时,就有更得当的认识它们的方法论了。
 爱发电(点击图片跳转)